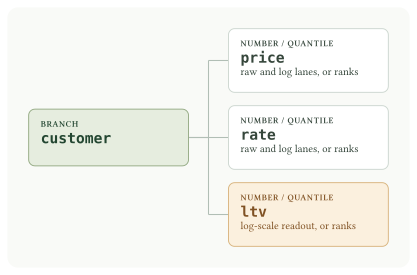
"""P079: compare Number's lanes and log-scale readout with Quantile ranks across numeric regimes."""

from collections.abc import Callable, Iterator
from functools import partial

import lightning.pytorch as lit
import numpy as np
import pyarrow as pa
import relflow as rf
from reporting import report

PROOF_ID = "P079"
BUDGET = 500
LONG_BUDGET = 1500
BATCH_SIZE = 128
TRAIN_ROWS = 8192
TEST_ROWS = 4096
PRICE_SCALE = 1.2
HEAVY_SCALE = 2.5
MODERATE_SCALE = 1.5
NOISE = 0.3
SPAN = 50.0
ADDITIVE_NOISE = 2.0
OFFSET = 1000.0
INPUTS = {
    "heavy": ("price", "rate"),
    "moderate": ("price", "rate"),
    "additive": ("left", "right"),
    "narrow": ("left", "right"),
}
TARGETS = {"heavy": "ltv", "moderate": "ltv", "additive": "total", "narrow": "total"}
ARMS = (
    ("heavy", "number", "number", BUDGET),
    ("heavy", "rank", "number", BUDGET),
    ("heavy", "number", "rank", BUDGET),
    ("heavy", "number", "number", LONG_BUDGET),
    ("moderate", "number", "number", BUDGET),
    ("moderate", "rank", "number", BUDGET),
    ("additive", "number", "number", BUDGET),
    ("additive", "rank", "number", BUDGET),
    ("narrow", "number", "number", BUDGET),
    ("narrow", "rank", "number", BUDGET),
)


def multiplicative(*, rows: int, seed: int, scale: float = HEAVY_SCALE) -> Iterator[dict]:
    """Lognormal prices and rates multiply under symmetric log noise; ``scale`` sets the rate tail."""
    rng = np.random.default_rng(seed)
    price = np.exp(3.0 + PRICE_SCALE * rng.standard_normal(rows))
    rate = np.exp(scale * rng.standard_normal(rows))
    ltv = price * np.sqrt(rate) * np.exp(NOISE * rng.standard_normal(rows))
    for index in range(rows):
        yield {"price": float(price[index]), "rate": float(rate[index]), "ltv": float(ltv[index])}


def additive(*, rows: int, seed: int, offset: float = 0.0) -> Iterator[dict]:
    """Two uniform terms add under symmetric noise; ``offset`` moves the total away from zero."""
    rng = np.random.default_rng(seed)
    left = rng.uniform(-SPAN, SPAN, rows)
    right = rng.uniform(-SPAN, SPAN, rows)
    total = offset + left + right + ADDITIVE_NOISE * rng.standard_normal(rows)
    for index in range(rows):
        yield {"left": float(left[index]), "right": float(right[index]), "total": float(total[index])}


RECORDS: dict[str, Callable[..., Iterator[dict]]] = {
    "heavy": multiplicative,
    "moderate": partial(multiplicative, scale=MODERATE_SCALE),
    "additive": additive,
    "narrow": partial(additive, offset=OFFSET),
}


def median(task: str, rows: list[dict]) -> np.ndarray:
    """Conditional median of the target given the visible inputs."""
    if task == "additive":
        return np.asarray([row["left"] + row["right"] for row in rows])
    if task == "narrow":
        return np.asarray([OFFSET + row["left"] + row["right"] for row in rows])
    return np.asarray([row["price"] * np.sqrt(row["rate"]) for row in rows])


def build(task: str, inputs: str, target: str) -> rf.Model:
    scalar = rf.Quantile if inputs == "rank" else rf.Number
    fields: dict[str, object] = {name: scalar for name in INPUTS[task]}
    if target == "rank":
        fields[TARGETS[task]] = rf.Quantile(objective="mae", mask=True)
    else:
        fields[TARGETS[task]] = rf.Number(mask=True)
    return rf.Model.xs(fields=fields)


def fit(model: rf.Model, train, validate, seed: int, steps: int | None, accelerator: str, budget: int) -> int:
    data = rf.SyntheticDataModule(train=train, validate=validate, seed=seed)
    model.fit(
        data,
        batch_size=BATCH_SIZE,
        learning_rate=0.002,
        early_stopping=False,
        rollback=False,
        precision="32-true",
        strategy="auto",
        accelerator=accelerator,
        devices=1,
        max_epochs=-1,
        max_steps=budget if steps is None else min(steps, budget),
        deterministic=True,
        logger=False,
        enable_checkpointing=False,
        enable_progress_bar=False,
        enable_model_summary=False,
        num_sanity_val_steps=0,
    )
    model.eval()
    return model.trainer.global_step


def predict(model: rf.Model, task: str, rows: list[dict]) -> np.ndarray:
    visible = [{name: row[name] for name in INPUTS[task]} for row in rows]
    predictions = model.predict(pa.Table.from_pylist(visible))["predictions"].to_pylist()
    return np.asarray([row[TARGETS[task]]["content"] for row in predictions], dtype=np.float64)


def evaluate(output: np.ndarray, control: np.ndarray, reference: dict, bulk: np.ndarray | None) -> dict:
    target, oracle = reference["target"], reference["oracle"]
    error = np.abs(output - target)
    mae = float(error.mean())
    beyond = (output < reference["support"][0]) | (output > reference["support"][1])
    result = {
        "mae": mae,
        "oracle_ratio": mae / reference["oracle_mae"],
        "normalized_mae": mae / reference["baseline_mae"],
        "median_distance": float(np.mean(np.abs(output - oracle))),
        "shuffled_normalized_mae": float(np.mean(np.abs(control - target))) / reference["baseline_mae"],
        "beyond_support_rows": int(beyond.sum()),
        "beyond_support_error_share": float(error[beyond].sum() / error.sum()) if error.sum() else 0.0,
        "finite": bool(np.isfinite(output).all() and np.isfinite(control).all()),
    }
    if bulk is not None:
        tail = reference["tail"]
        irreducible = np.abs(target - oracle)
        result["bulk_oracle_ratio"] = float(error[bulk].mean() / irreducible[bulk].mean())
        result["tail_oracle_ratio"] = float(error[tail].mean() / irreducible[tail].mean())
    return result


def run(seed: int, steps: int | None, accelerator: str) -> tuple[dict, dict]:
    stream = seed * 100
    metrics: dict = {"train_rows": TRAIN_ROWS, "test_rows": TEST_ROWS, "budget": BUDGET, "long_budget": LONG_BUDGET}
    for offset, task in ((0, "heavy"), (20, "moderate"), (10, "additive"), (30, "narrow")):
        records, name = RECORDS[task], TARGETS[task]
        training = list(records(rows=TRAIN_ROWS, seed=stream + offset + 1))
        test = list(records(rows=TEST_ROWS, seed=stream + offset + 3))
        target = np.asarray([row[name] for row in test])
        oracle = median(task, test)
        observed = np.asarray([row[name] for row in training])
        constant = float(np.median(observed))
        reference = {
            "target": target,
            "oracle": oracle,
            "oracle_mae": float(np.mean(np.abs(target - oracle))),
            "baseline_mae": float(np.mean(np.abs(target - constant))),
            "support": (float(observed.min()), float(observed.max())),
        }
        bulk = None
        if task in ("heavy", "moderate"):
            columns = {key: np.asarray([row[key] for row in training]) for key in INPUTS[task]}
            low = {key: np.percentile(values, 10) for key, values in columns.items()}
            high = {key: np.percentile(values, 90) for key, values in columns.items()}
            extreme = {key: np.percentile(values, 95) for key, values in columns.items()}
            bulk = np.all([[low[key] <= row[key] <= high[key] for key in INPUTS[task]] for row in test], axis=1)
            reference["tail"] = np.any([[row[key] > extreme[key] for key in INPUTS[task]] for row in test], axis=1)
        permutation = np.random.default_rng(stream + offset + 4).permutation(TEST_ROWS)
        shuffled = [{**test[index], name: row[name]} for row, index in zip(test, permutation, strict=True)]
        metrics[task] = {
            "oracle_mae": reference["oracle_mae"],
            "baseline_mae": reference["baseline_mae"],
            "training_median": constant,
            "training_support": list(reference["support"]),
            "bulk_rows": None if bulk is None else int(bulk.sum()),
            "tail_rows": None if bulk is None else int(reference["tail"].sum()),
        }
        for arm_task, inputs, space, budget in ARMS:
            if arm_task != task:
                continue
            lit.seed_everything(seed, workers=True)
            model = build(task, inputs, space)
            updates = fit(
                model,
                partial(records, rows=TRAIN_ROWS, seed=stream + offset + 1),
                partial(records, rows=1024, seed=stream + offset + 2),
                seed,
                steps,
                accelerator,
                budget,
            )
            result = evaluate(predict(model, task, test), predict(model, task, shuffled), reference, bulk)
            result["steps"] = updates
            metrics[task][f"{inputs}_{space}" + ("_long" if budget != BUDGET else "")] = result
    arms = [value for task in TARGETS for value in metrics[task].values() if isinstance(value, dict)]
    checks = {}
    for task in TARGETS:
        label = {
            "heavy": "Heavy tails",
            "moderate": "Moderate tails",
            "additive": "Additive",
            "narrow": "Far from zero",
        }[task]
        checks[f"{label}: Number reaches 1.5 times the oracle MAE"] = (
            metrics[task]["number_number"]["oracle_ratio"] <= 1.5
        )
        checks[f"{label}: Number stays within 10 percent of Quantile inputs"] = (
            metrics[task]["number_number"]["mae"] <= 1.10 * metrics[task]["rank_number"]["mae"]
        )
    checks["Shuffled inputs lose the relationship in every arm"] = all(
        arm["shuffled_normalized_mae"] >= 0.90 for arm in arms
    )
    checks["Every arm produces finite predictions"] = all(arm["finite"] for arm in arms)
    return metrics, checks


if __name__ == "__main__":
    report(PROOF_ID, run, seed=7901)