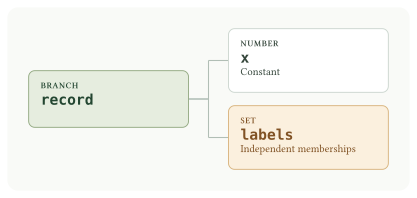
"""P063: membership probability and coverage have explicit support."""

from collections.abc import Iterator
from functools import partial

import lightning.pytorch as lit
import numpy as np
import pyarrow as pa
from reporting import report

import relflow as rf
from relflow.helpers.resize import Resize

PROOF_ID = "P063"
BUDGET = 400


def records(*, rows: int, seed: int) -> Iterator[dict]:
    rng = np.random.default_rng(seed)
    for red, blue in rng.random((rows, 2)) < np.asarray([0.9, 0.2]):
        yield {"x": 0.0, "labels": [name for name, present in (("red", red), ("blue", blue)) if present]}


def build(size: int) -> rf.Model:
    model = rf.Model(
        d_model=16,
        n_layers=1,
        n_heads=2,
        batch_size=128,
        dropout=0.0,
        x=rf.Number,
        labels=rf.Set(p_unavailable=1.0, mask=True),
    )
    # Experimental storage control only: allocation is not a schema option.
    node = model.nodes["/labels"]
    resize = Resize()
    resize.embedding(node.embedder.embeddings["content"], size)
    resize.linear(node.decoder.linears["content"], size)
    node.embedder.counters["content"].resize(size, resize)
    resize.attribute(node.embedder.vocab, "size", size)
    resize.commit()
    model.optimizer = rf.adamw(learning_rate=0.002)
    return model


def run(seed: int, steps: int | None, accelerator: str) -> tuple[dict, dict]:
    metrics, checks = {}, {}
    prior = np.asarray([0.9, 0.2])
    oracle = float(np.mean(-prior * np.log(prior) - (1 - prior) * np.log1p(-prior)))
    metrics["oracle_nll"] = oracle
    for size in (2, 512):
        lit.seed_everything(seed, workers=True)
        model = build(size)
        data = rf.SyntheticDataModule(
            model=model,
            train=partial(records, rows=32768, seed=seed + 1),
            validate=partial(records, rows=1024, seed=seed + 2),
            seed=seed,
        )
        trainer = lit.Trainer(
            accelerator=accelerator,
            devices=1,
            max_epochs=-1,
            max_steps=BUDGET if steps is None else min(steps, BUDGET),
            deterministic=True,
            logger=False,
            enable_checkpointing=False,
            enable_progress_bar=False,
            enable_model_summary=False,
            num_sanity_val_steps=0,
        )
        trainer.fit(model, datamodule=data)
        vocabulary = rf.Set.vocabulary(model, "/labels")
        written = model.predict(pa.table({"x": [0.0]}))["predictions"].to_pylist()[0]["labels"]["content"]
        probabilities = {item["value"]: item["probability"] for item in written}
        p = np.asarray([probabilities[name] for name in ("red", "blue")]).clip(1e-7, 1 - 1e-7)
        excess = float(np.mean(-prior * np.log(p) - (1 - prior) * np.log1p(-p)) - oracle)
        metrics[f"capacity_{size}"] = {
            "probabilities": probabilities,
            "excess_nll": excess,
            "steps": trainer.global_step,
        }
        checks[f"{size}: probabilities recover prevalence within 0.06"] = bool(np.max(np.abs(p - prior)) < 0.06)
        checks[f"{size}: excess expected NLL below 0.02"] = excess < 0.02
        rows = [
            {"x": 0.0, "labels": labels}
            for labels in (["red", "novel"], ["novel"], [], ["blue"], None)
            for _ in range(128)
        ]
        results = []
        for order in (np.arange(len(rows)), np.random.default_rng(seed + 3).permutation(len(rows))):
            table = pa.Table.from_pylist([rows[index] for index in order])
            measured = trainer.validate(
                model, datamodule=rf.ArrowDataModule(model=model, validate=table, num_workers=0), verbose=False
            )[0]
            prefix = ".labels/validate."
            results.append(
                {key.removeprefix(prefix): float(value) for key, value in measured.items() if key.startswith(prefix)}
            )
        first, second = results
        metrics[f"coverage_{size}"] = {key: value if np.isfinite(value) else None for key, value in first.items()}
        checks[f"{size}: member counts include partial and all-OOV targets"] = (
            first.get("targets.known") == 256 and first.get("targets.unavailable") == 256
        )
        checks[f"{size}: member and complete-set coverage are one half"] = (
            first.get("coverage.content") == 0.5 and first.get("coverage.set") == 0.5
        )
        names = (
            "targets.known",
            "targets.unavailable",
            "coverage.content",
            "coverage.set",
            "loss.content",
            "accuracy.set",
            "f1.all",
        )
        checks[f"{size}: rebatching preserves epoch scores"] = all(
            name in first and name in second and abs(first[name] - second[name]) < 1e-5 for name in names
        )
        checks[f"{size}: evaluation never admits unknown labels"] = rf.Set.vocabulary(model, "/labels") == vocabulary
    return metrics, checks


if __name__ == "__main__":
    report(PROOF_ID, run, seed=7631)