Can it combine noisy measurements with missing readings?

Representation
Predict a signal from three noisy sensors, sometimes hiding one or more readings. An extra sensor carries no useful information.

Example

first: 0.5
second: 1.1
third: -0.2
hide_first: false
hide_second: false
hide_third: false
nuisance: 1.4
target: 0.4

The answer is shown here for explanation; it is hidden from the model when scored.

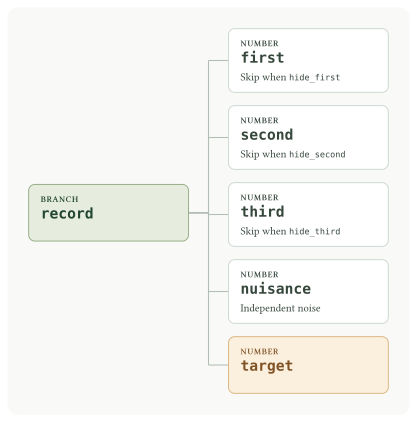
Model tree with record, first, second, third, nuisance, target. Amber cards are hidden prediction targets. Other fields provide the input.

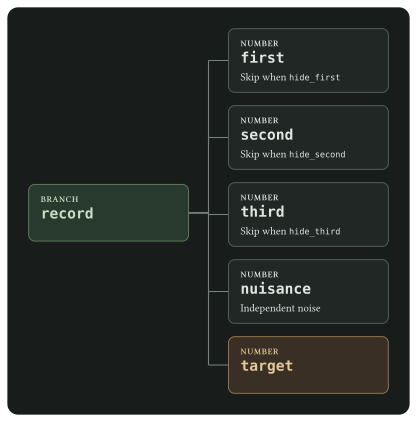
Model tree with record, first, second, third, nuisance, target. Amber cards are hidden prediction targets. Other fields provide the input.

Figure 1: Amber cards are hidden prediction targets. Other fields provide the input.

Comparison

Compare combined and single-sensor evidence, no evidence, an unseen visibility pattern, and a deliberately corrupted reading.

Result

P074 · Latest full run · Failing

Seed 7403 on cpu: 22 of 28 test checks met. The experiment did not meet every criterion. History: 1 of 3 full runs met every check, across 3 distinct seeds. History can include earlier source versions. The experiment code has changed since this run; these measurements describe its earlier version.

Comparison Latest measurement
Error with all three sensors 0.3671
Error with a corrupted sensor 4.824

Combining readings helps in all three seeds, but only one passes every check. Missing-evidence fallback remains inconsistent, and a corrupted visible sensor can sharply increase error.

Experiment details and code

Latest full run

Seed 7403, cpu, recorded 2026-09-22T17:13:53.942248+00:00. Outcome: not met.

Source fingerprint: ca7534706850700433430413a73858a3a83fd1113a345b68df04c81a36b30380. Python 3.12.10; Torch 2.12.0.

Measurement Value
steps 600
train_rows 4096
validation_rows 512
test_rows 2048
constant_baseline_mse 0.972894
patterns 111: unseen_pattern: False; mse: 0.367133; oracle_mse: 0.231228; oracle_expected_mse: 0.23491; distance_to_oracle: 0.142638; hidden_value_max_drift: 0; 110: unseen_pattern: False; mse: 0.379471; oracle_mse: 0.275746; oracle_expected_mse: 0.280702; distance_to_oracle: 0.105498; hidden_value_max_drift: 0; 101: unseen_pattern: True; mse: 0.532052; oracle_mse: 0.307462; oracle_expected_mse: 0.307036; distance_to_oracle: 0.226466; hidden_value_max_drift: 0; 100: unseen_pattern: False; mse: 0.533598; oracle_mse: 0.389987; oracle_expected_mse: 0.390244; distance_to_oracle: 0.137428; hidden_value_max_drift: 0; 011: unseen_pattern: False; mse: 0.442454; oracle_mse: 0.367284; oracle_expected_mse: 0.371134; distance_to_oracle: 0.0886348; hidden_value_max_drift: 0; 010: unseen_pattern: False; mse: 0.558828; oracle_mse: 0.491157; oracle_expected_mse: 0.5; distance_to_oracle: 0.0691753; hidden_value_max_drift: 0; 001: unseen_pattern: False; mse: 0.686725; oracle_mse: 0.586838; oracle_expected_mse: 0.590164; distance_to_oracle: 0.115321; hidden_value_max_drift: 0; 000: unseen_pattern: False; mse: 0.994918; oracle_mse: 0.972986; oracle_expected_mse: 1; distance_to_oracle: 0.0207688; hidden_value_max_drift: 0
joint_to_best_single_mse 0.688033
no_evidence_prediction_mean 0.0825778
no_evidence_prediction_std 0.118109
nuisance_permutation_rms_drift 0.0572894
corrupted_first_sensor_mse 4.82367
hidden_corruption_max_drift 0
Behavioral checks
Behavioral check Outcome
111: finite predictions Met
111: tracks conditional mean Not met
111: hidden sensor and target values cannot affect predictions Met
110: finite predictions Met
110: tracks conditional mean Not met
110: hidden sensor and target values cannot affect predictions Met
101: finite predictions Met
101: tracks conditional mean Not met
101: hidden sensor and target values cannot affect predictions Met
100: finite predictions Met
100: tracks conditional mean Not met
100: hidden sensor and target values cannot affect predictions Met
011: finite predictions Met
011: tracks conditional mean Met
011: hidden sensor and target values cannot affect predictions Met
010: finite predictions Met
010: tracks conditional mean Met
010: hidden sensor and target values cannot affect predictions Met
001: finite predictions Met
001: tracks conditional mean Not met
001: hidden sensor and target values cannot affect predictions Met
000: finite predictions Met
000: tracks conditional mean Met
000: hidden sensor and target values cannot affect predictions Met
Joint evidence improves MSE by at least 15 percent over every single sensor Met
Absent evidence returns the zero prior mean Not met
Unrelated sensor has small prediction influence Met
Skipping the corrupted sensor restores the paired two-sensor prediction Met

Full run history

Runs may include earlier source versions. Repeating a seed is not an independent seed check.

Seed Outcome Recorded Code fingerprint
7401 not met 2026-09-22T17:13:25.162307+00:00 4861232cd12cf38bf20b87ef02cf0d1a2ae7e72ea89d27a607b28ea3e6cdd1f1
7402 met 2026-09-22T17:13:40.020920+00:00 4861232cd12cf38bf20b87ef02cf0d1a2ae7e72ea89d27a607b28ea3e6cdd1f1
7403 not met 2026-09-22T17:13:53.942248+00:00 4861232cd12cf38bf20b87ef02cf0d1a2ae7e72ea89d27a607b28ea3e6cdd1f1

Recorded results.

Run this experiment

Proof execution is optional and separate from building this site. Use a RelFlow build matching the recorded provenance; replace the wheel path below with that artifact. Run from this documentation repository’s root:

uv run --with /path/to/matching-relflow.whl python proofs/run.py P074

Or, from a prepared proof environment, run the self-contained script directly:

PYTHONPATH=proofs python proofs/representation/incomplete_evidence.py

Add --accelerator gpu for CUDA or --seed 42 for another seeded experiment. --steps 2 checks execution with a short training budget; it is recorded as a smoke run.

Download the complete proof.

Process and information boundary

Independently draw z ~ Normal(0,1) and three sensors x_i = z + e_i, with independent Gaussian errors of standard deviations 0.8, 1.0, and 1.2. A fourth, nuisance reading is independent Normal(0,1). The target is z and is always hidden. For any visible subset V, the exact conditional mean is sum(x_i / sigma_i**2) / (1 + sum(1 / sigma_i**2)); its conditional variance is 1 / (1 + sum(1 / sigma_i**2)). With no sensors visible, the mean is zero.

Training and predeclared measurements

Train an xs model for 600 AdamW updates at learning rate 0.002, batch size 64, with independent 4,096/512 training/validation rows. Missingness begins with three independent Bernoulli(0.5) flags; fitting rejects only the pattern with first and third visible and second hidden. This conditioning makes the retained flags dependent on one another, but keeps them independent of every numerical value. No selector is an embedded field.

Apply all eight fixed patterns to the same 2,048 independent test records. For each, record prediction MSE, empirical oracle MSE, and squared distance to the conditional mean. Predeclared gates require mean-squared distance to the oracle below 0.10 for seen patterns and below 0.15 for the unseen one. Joint evidence must improve MSE by at least 15% over the best single sensor. The no-evidence prediction must have absolute mean below 0.20 and standard deviation below 0.10. Permuting nuisance readings must change predictions by RMS less than 0.12. Hidden-value poisoning must have maximum effect <1e-5.

Add six to the first visible sensor in a separate stress control. Its effect is diagnostic: this model was not trained to identify corrupted sensors. Hiding that same corrupted sensor must exactly recover its corresponding two-sensor prediction. All comparisons use the final fixed-budget model.

Complete experiment code

Code
"""P074: Gaussian evidence fusion, missingness transfer, and a known oracle."""

from collections.abc import Iterator
from functools import partial
from itertools import product

import lightning.pytorch as lit
import numpy as np
import pyarrow as pa
from reporting import report

import relflow as rf

PROOF_ID = "P074"
BUDGET = 600
TRAIN_ROWS = 4096
TEST_ROWS = 2048
SENSORS = ("first", "second", "third")
NOISE = np.asarray([0.8, 1.0, 1.2])
UNSEEN = (False, True, False)
PATTERNS = tuple(product((False, True), repeat=3))


def records(*, rows: int, seed: int, training: bool = False) -> Iterator[dict]:
    rng = np.random.default_rng(seed)
    target = rng.normal(size=rows)
    sensors = target[:, None] + rng.normal(size=(rows, 3)) * NOISE
    nuisance = rng.normal(size=rows)
    hidden = rng.random((rows, 3)) < 0.5
    if training:
        # Condition only on visibility, never on values or targets.
        excluded = np.all(hidden == UNSEEN, axis=1)
        while excluded.any():
            hidden[excluded] = rng.random((int(excluded.sum()), 3)) < 0.5
            excluded = np.all(hidden == UNSEEN, axis=1)
    for values, mask, noise, answer in zip(sensors, hidden, nuisance, target, strict=True):
        yield {
            **{name: float(value) for name, value in zip(SENSORS, values, strict=True)},
            **{f"hide_{name}": bool(value) for name, value in zip(SENSORS, mask, strict=True)},
            "nuisance": float(noise),
            "target": float(answer),
        }


def build() -> rf.Model:
    return rf.Model.xs(
        batch_size=64,
        fields={
            **{name: rf.Number(mask=rf.Mask(query=f"hide_{name}", skip=True, dropout=False)) for name in SENSORS},
            "nuisance": rf.Number,
            "target": rf.Number(mask=True, objective="mse"),
        },
    )


def select(rows: list[dict], pattern: tuple[bool, ...]) -> list[dict]:
    return [{**row, **{f"hide_{name}": hidden for name, hidden in zip(SENSORS, pattern, strict=True)}} for row in rows]


def oracle(rows: list[dict], pattern: tuple[bool, ...]) -> tuple[np.ndarray, float]:
    precision = np.asarray([not hidden for hidden in pattern]) / NOISE**2
    readings = np.asarray([[row[name] for name in SENSORS] for row in rows])
    variance = float(1.0 / (1.0 + precision.sum()))
    return readings @ precision * variance, variance


def prediction(model: rf.Model, rows: list[dict]) -> np.ndarray:
    output = model.predict(pa.Table.from_pylist(rows))["predictions"].to_pylist()
    return np.asarray([row["target"]["content"] for row in output], dtype=np.float64)


def run(seed: int, steps: int | None, accelerator: str) -> tuple[dict, dict]:
    lit.seed_everything(seed, workers=True)
    model = build()
    model.optimizer = rf.adamw(learning_rate=0.002)
    data = rf.SyntheticDataModule(
        model=model,
        train=partial(records, rows=TRAIN_ROWS, seed=seed * 100 + 1, training=True),
        validate=partial(records, rows=512, seed=seed * 100 + 2, training=True),
        seed=seed,
    )
    trainer = lit.Trainer(
        accelerator=accelerator,
        devices=1,
        max_epochs=-1,
        max_steps=BUDGET if steps is None else min(steps, BUDGET),
        deterministic=True,
        logger=False,
        enable_checkpointing=False,
        enable_progress_bar=False,
        enable_model_summary=False,
        num_sanity_val_steps=0,
    )
    trainer.fit(model, datamodule=data)
    model.eval()
    test = list(records(rows=TEST_ROWS, seed=seed * 100 + 3))
    actual = np.asarray([row["target"] for row in test])
    train_mean = float(np.mean([row["target"] for row in records(rows=TRAIN_ROWS, seed=seed * 100 + 1, training=True)]))
    metrics = {
        "steps": trainer.global_step,
        "train_rows": TRAIN_ROWS,
        "validation_rows": 512,
        "test_rows": TEST_ROWS,
        "constant_baseline_mse": float(np.mean((actual - train_mean) ** 2)),
        "patterns": {},
    }
    checks = {}
    predicted_by_pattern = {}
    for pattern in PATTERNS:
        key = "".join("0" if hidden else "1" for hidden in pattern)
        selected = select(test, pattern)
        predicted = prediction(model, selected)
        predicted_by_pattern[pattern] = predicted
        conditional_mean, variance = oracle(selected, pattern)
        poisoned = [
            {
                **row,
                **{name: 1000.0 for name, hidden in zip(SENSORS, pattern, strict=True) if hidden},
                "target": -1000.0,
            }
            for row in selected
        ]
        measured = {
            "unseen_pattern": pattern == UNSEEN,
            "mse": float(np.mean((predicted - actual) ** 2)),
            "oracle_mse": float(np.mean((conditional_mean - actual) ** 2)),
            "oracle_expected_mse": variance,
            "distance_to_oracle": float(np.mean((predicted - conditional_mean) ** 2)),
            "hidden_value_max_drift": float(np.max(np.abs(predicted - prediction(model, poisoned)))),
        }
        metrics["patterns"][key] = measured
        checks[f"{key}: finite predictions"] = bool(np.isfinite(predicted).all())
        checks[f"{key}: tracks conditional mean"] = measured["distance_to_oracle"] < (
            0.15 if pattern == UNSEEN else 0.10
        )
        checks[f"{key}: hidden sensor and target values cannot affect predictions"] = (
            measured["hidden_value_max_drift"] < 1e-5
        )
    single_mse = [metrics["patterns"][key]["mse"] for key in ("100", "010", "001")]
    joint_mse = metrics["patterns"]["111"]["mse"]
    metrics["joint_to_best_single_mse"] = joint_mse / min(single_mse)
    checks["Joint evidence improves MSE by at least 15 percent over every single sensor"] = (
        metrics["joint_to_best_single_mse"] < 0.85
    )
    no_evidence = predicted_by_pattern[(True, True, True)]
    metrics["no_evidence_prediction_mean"] = float(no_evidence.mean())
    metrics["no_evidence_prediction_std"] = float(no_evidence.std())
    checks["Absent evidence returns the zero prior mean"] = (
        abs(float(no_evidence.mean())) < 0.20 and float(no_evidence.std()) < 0.10
    )
    complete = select(test, (False, False, False))
    order = np.random.default_rng(seed * 100 + 4).permutation(TEST_ROWS)
    nuisance = [{**row, "nuisance": test[index]["nuisance"]} for row, index in zip(complete, order, strict=True)]
    metrics["nuisance_permutation_rms_drift"] = float(
        np.sqrt(np.mean((prediction(model, nuisance) - predicted_by_pattern[(False, False, False)]) ** 2))
    )
    checks["Unrelated sensor has small prediction influence"] = metrics["nuisance_permutation_rms_drift"] < 0.12
    corrupted = [{**row, "first": row["first"] + 6.0} for row in complete]
    metrics["corrupted_first_sensor_mse"] = float(np.mean((prediction(model, corrupted) - actual) ** 2))
    hidden_corrupted = select(corrupted, (True, False, False))
    metrics["hidden_corruption_max_drift"] = float(
        np.max(np.abs(prediction(model, hidden_corrupted) - predicted_by_pattern[(True, False, False)]))
    )
    checks["Skipping the corrupted sensor restores the paired two-sensor prediction"] = (
        metrics["hidden_corruption_max_drift"] < 1e-5
    )
    return metrics, checks


if __name__ == "__main__":
    report(PROOF_ID, run, seed=7401)