"""P051: sampled cross-field reconstruction with deterministic inference controls."""

from collections.abc import Iterator
from functools import partial

import lightning.pytorch as lit
import numpy as np
import pyarrow as pa
from reporting import report

import relflow as rf

PROOF_ID = "P051"
BUDGET = 400


def records(*, rows: int, seed: int) -> Iterator[dict]:
    rng = np.random.default_rng(seed)
    for value in rng.uniform(-1.0, 1.0, rows):
        yield {"x": float(value), "y": float(2 * value + 0.3), "hide_x": False, "hide_y": False}


def build() -> rf.Model:
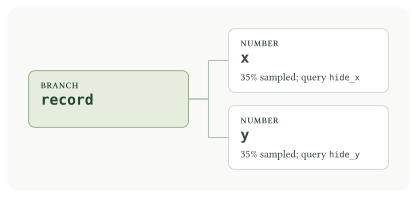
    return rf.Model.xs(
        batch_size=64,
        fields={
            name: rf.Number(
                objective="mse",
                mask=(
                    rf.Mask(rate=0.35, reconstruct=True),
                    rf.Mask(query=f"hide_{name}", reconstruct=True),
                ),
            )
            for name in ("x", "y")
        },
    )


def prediction(model: rf.Model, rows: list[dict], target: str) -> np.ndarray:
    output = model.predict(pa.Table.from_pylist(rows))["predictions"].to_pylist()
    return np.asarray([row[target]["content"] for row in output], dtype=np.float64)


def error(actual: np.ndarray, predicted: np.ndarray | float) -> float:
    return float(np.sqrt(np.mean((actual - predicted) ** 2)))


def run(seed: int, steps: int | None, accelerator: str) -> tuple[dict, dict]:
    lit.seed_everything(seed, workers=True)
    model = build()
    model.optimizer = rf.adamw(learning_rate=0.002)
    data = rf.SyntheticDataModule(
        model=model,
        train=partial(records, rows=4096, seed=seed + 1),
        validate=partial(records, rows=512, seed=seed + 2),
        seed=seed,
    )
    trainer = lit.Trainer(
        accelerator=accelerator,
        devices=1,
        max_epochs=-1,
        max_steps=BUDGET if steps is None else min(steps, BUDGET),
        deterministic=True,
        logger=False,
        enable_checkpointing=False,
        enable_progress_bar=False,
        enable_model_summary=False,
        num_sanity_val_steps=0,
    )
    trainer.fit(model, datamodule=data)
    model.eval()
    train = list(records(rows=4096, seed=seed + 1))
    test = list(records(rows=2048, seed=seed + 3))
    source = pa.Table.from_pylist(test)
    # Training-mode audits must not update the fitted model with held-out moments.
    probe = build()
    encoded = [probe.encode(source, strata="train", seed=seed, epoch=epoch) for epoch in (0, 0, 1)]
    ordinary = probe.encode(source, strata="predict")
    metrics = {"steps": trainer.global_step, "directions": {}}
    checks = {}
    order = np.random.default_rng(seed + 4).permutation(len(test))
    for target, context in (("y", "x"), ("x", "y")):
        selected = [{**row, f"hide_{target}": True} for row in test]
        actual = np.asarray([row[target] for row in test])
        baseline = error(actual, float(np.mean([row[target] for row in train])))
        predicted = prediction(model, selected, target)
        shuffled = [{**row, context: test[index][context]} for row, index in zip(selected, order, strict=True)]
        hidden = [{**row, f"hide_{context}": True} for row in selected]
        poisoned = [{**row, target: 1000.0 + index} for index, row in enumerate(selected)]
        measured = {
            "rmse": error(actual, predicted),
            "baseline_rmse": baseline,
            "nrmse": error(actual, predicted) / baseline,
            "shuffled_nrmse": error(actual, prediction(model, shuffled, target)) / baseline,
            "both_hidden_nrmse": error(actual, prediction(model, hidden, target)) / baseline,
            "hidden_value_drift": float(np.max(np.abs(predicted - prediction(model, poisoned, target)))),
        }
        masks = [batch[f"/{target}"].trainable for batch in encoded]
        measured["sampled_fraction"] = float(masks[0].float().mean())
        metrics["directions"][target] = measured
        checks[f"{target}: held-out nRMSE below 0.25"] = measured["nrmse"] < 0.25
        checks[f"{target}: shuffled context nRMSE above 0.85"] = measured["shuffled_nrmse"] > 0.85
        checks[f"{target}: no context nRMSE above 0.85"] = measured["both_hidden_nrmse"] > 0.85
        checks[f"{target}: hidden values cannot affect predictions"] = measured["hidden_value_drift"] < 1e-5
        checks[f"{target}: sampling is partial"] = 0.25 < measured["sampled_fraction"] < 0.45
        checks[f"{target}: sampling repeats within an epoch"] = bool((masks[0] == masks[1]).all())
        checks[f"{target}: sampling changes across epochs"] = bool((masks[0] != masks[2]).any())
        checks[f"{target}: ordinary prediction requests no reconstruction"] = not bool(
            ordinary[f"/{target}"].inferred.any()
        )
    return metrics, checks


if __name__ == "__main__":
    report(PROOF_ID, run, seed=5101)