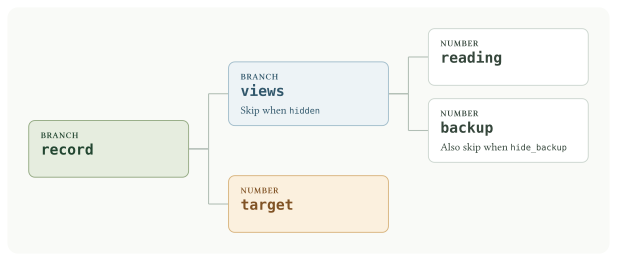
"""P053: redundant-view learning under composed branch and leaf skip policies."""

from collections.abc import Iterator
from functools import partial

import lightning.pytorch as lit
import numpy as np
import pyarrow as pa
from reporting import report

import relflow as rf

PROOF_ID = "P053"
BUDGET = 500


def records(*, rows: int, seed: int) -> Iterator[dict]:
    rng = np.random.default_rng(seed)
    for _ in range(rows):
        value = float(rng.uniform(-1.0, 1.0))
        yield {
            "views": [
                {
                    "reading": value,
                    "backup": 2 * value + 0.1,
                    "hidden": bool(rng.random() < 0.5),
                    "hide_backup": bool(rng.random() < 0.5),
                }
                for _ in range(2)
            ],
            "target": 1.5 * value - 0.2,
        }


def build() -> rf.Model:
    return rf.Model.xs(
        batch_size=64,
        views=rf.Branch(
            length=2,
            mask=rf.Mask(query="hidden", skip=True, dropout=False),
            reading=rf.Number,
            backup=rf.Number(mask=rf.Mask(query="hide_backup", skip=True, dropout=False)),
        ),
        target=rf.Number(mask=True, objective="mse"),
    )


def prediction(model: rf.Model, rows: list[dict]) -> np.ndarray:
    output = model.predict(pa.Table.from_pylist(rows))["predictions"].to_pylist()
    return np.asarray([row["target"]["content"] for row in output], dtype=np.float64)


def run(seed: int, steps: int | None, accelerator: str) -> tuple[dict, dict]:
    lit.seed_everything(seed, workers=True)
    model = build()
    model.optimizer = rf.adamw(learning_rate=0.002)
    data = rf.SyntheticDataModule(
        model=model,
        train=partial(records, rows=4096, seed=seed + 1),
        validate=partial(records, rows=512, seed=seed + 2),
        seed=seed,
    )
    trainer = lit.Trainer(
        accelerator=accelerator,
        devices=1,
        max_epochs=-1,
        max_steps=BUDGET if steps is None else min(steps, BUDGET),
        deterministic=True,
        logger=False,
        enable_checkpointing=False,
        enable_progress_bar=False,
        enable_model_summary=False,
        num_sanity_val_steps=0,
    )
    trainer.fit(model, datamodule=data)
    model.eval()
    train = list(records(rows=4096, seed=seed + 1))
    test = list(records(rows=2048, seed=seed + 3))
    actual = np.asarray([row["target"] for row in test])
    baseline = float(np.sqrt(np.mean((actual - np.mean([row["target"] for row in train])) ** 2)))
    metrics = {"steps": trainer.global_step, "baseline_rmse": baseline, "patterns": {}}
    checks = {}
    for pattern in ((False, False), (True, False), (False, True), (True, True)):
        name = "".join("hidden" if hidden else "visible" for hidden in pattern)
        selected = [
            {
                **row,
                "views": [
                    {**view, "hidden": hidden, "hide_backup": False}
                    for view, hidden in zip(row["views"], pattern, strict=True)
                ],
            }
            for row in test
        ]
        predicted = prediction(model, selected)
        poisoned = [
            {
                "target": 1000.0,
                "views": [
                    {**view, "reading": 1000.0, "backup": -1000.0} if view["hidden"] else view for view in row["views"]
                ],
            }
            for row in selected
        ]
        measured = {
            "nrmse": float(np.sqrt(np.mean((predicted - actual) ** 2))) / baseline,
            "hidden_value_drift": float(np.max(np.abs(predicted - prediction(model, poisoned)))),
        }
        metrics["patterns"][name] = measured
        checks[f"{name}: expected information boundary"] = (
            measured["nrmse"] > 0.85 if all(pattern) else measured["nrmse"] < 0.30
        )
        checks[f"{name}: skipped values cannot affect predictions"] = measured["hidden_value_drift"] < 1e-5
    order = np.random.default_rng(seed + 4).permutation(len(test))
    shuffled = [
        {
            "target": row["target"],
            "views": [{**view, "hidden": False, "hide_backup": False} for view in test[index]["views"]],
        }
        for row, index in zip(test, order, strict=True)
    ]
    metrics["shuffled_nrmse"] = float(np.sqrt(np.mean((prediction(model, shuffled) - actual) ** 2))) / baseline
    checks["Shuffling available evidence removes accuracy"] = metrics["shuffled_nrmse"] > 0.85
    fields = model.encode(pa.Table.from_pylist(test), strata="predict")
    for name in ("reading", "backup"):
        expected = np.asarray(
            [
                [not (view["hidden"] or (name == "backup" and view["hide_backup"])) for view in row["views"]]
                for row in test
            ]
        )
        present = fields[f"/views/{name}"].present.cpu().numpy().reshape(expected.shape)
        checks[f"{name}: ancestor and local skips compose"] = bool(np.array_equal(present, expected))
    return metrics, checks


if __name__ == "__main__":
    report(PROOF_ID, run, seed=5301)